双设备架构
将完整模型集中到 Thor,使 Orin Nano 的内存主要用于仿真、观测和控制链路。这里是系统职责拆分,神经网络层之间没有跨设备切分。
拆分推理框架图
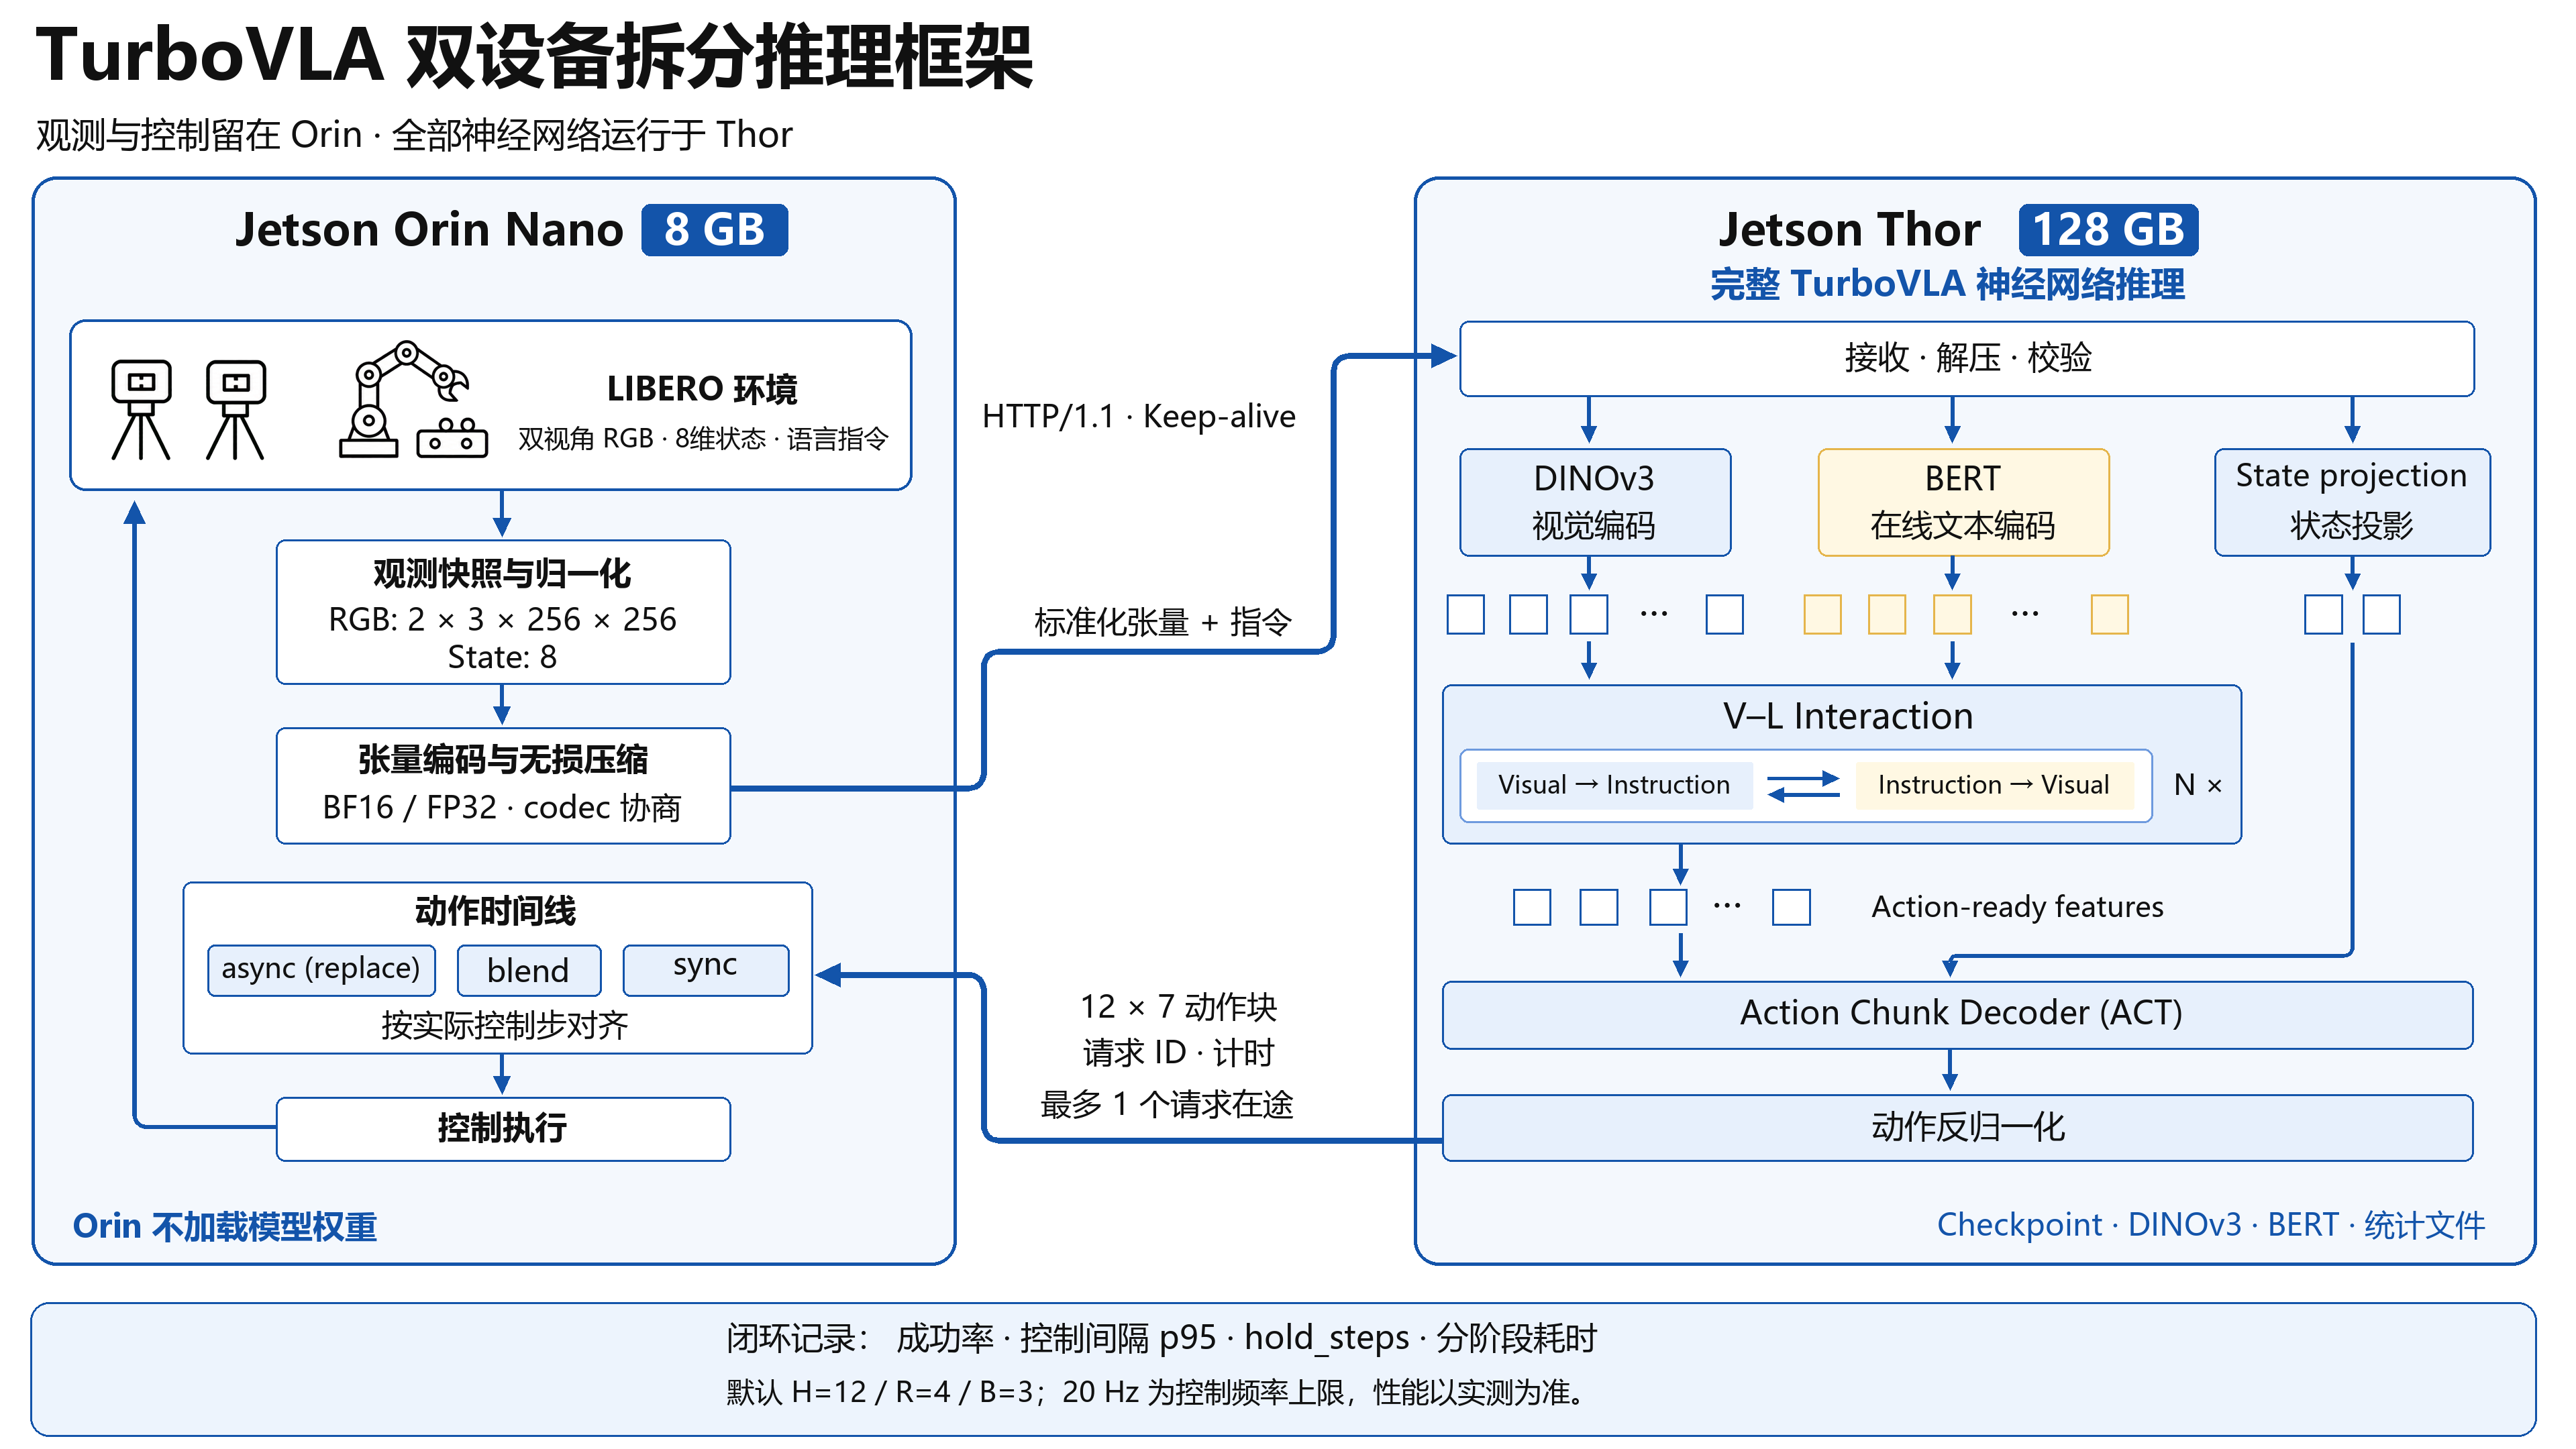
框架图由 DDS 生成后重建为原生文本、纯色形状及单个连续箭头;相机与机械臂为独立图标对象。图中 token 方块仅作结构示意,实际数量以配置为准。
数据走向
| 环节 | 位置 | 输入 → 输出 | 代码 |
|---|---|---|---|
| 观测快照 | Orin | 两路相机、位姿、夹爪状态 → 独立副本 | async_rollout.py::submit() |
| 预处理 | Orin | 256×256 RGB、8 维状态 → 归一化张量 | split/client.py |
| 编码 | Orin | 张量 + JSON 头 → 无损压缩报文 | split/protocol.py |
| 神经推理 | Thor | DINOv3 + 在线 BERT → 双向 V–L 交互 → ACT | models/turbovla.py |
| 状态融合 | Thor | 8 维状态 → state tokens → ACT memory | models/action_head.py |
| 动作还原 | Thor | 归一化输出 → 相对位姿 + 离散夹爪 | evaluation/suite_policy.py |
| 对齐与执行 | Orin | 动作块 → 实际控制步时间线 → env.step() | evaluation/async_rollout.py |
模型继承关系
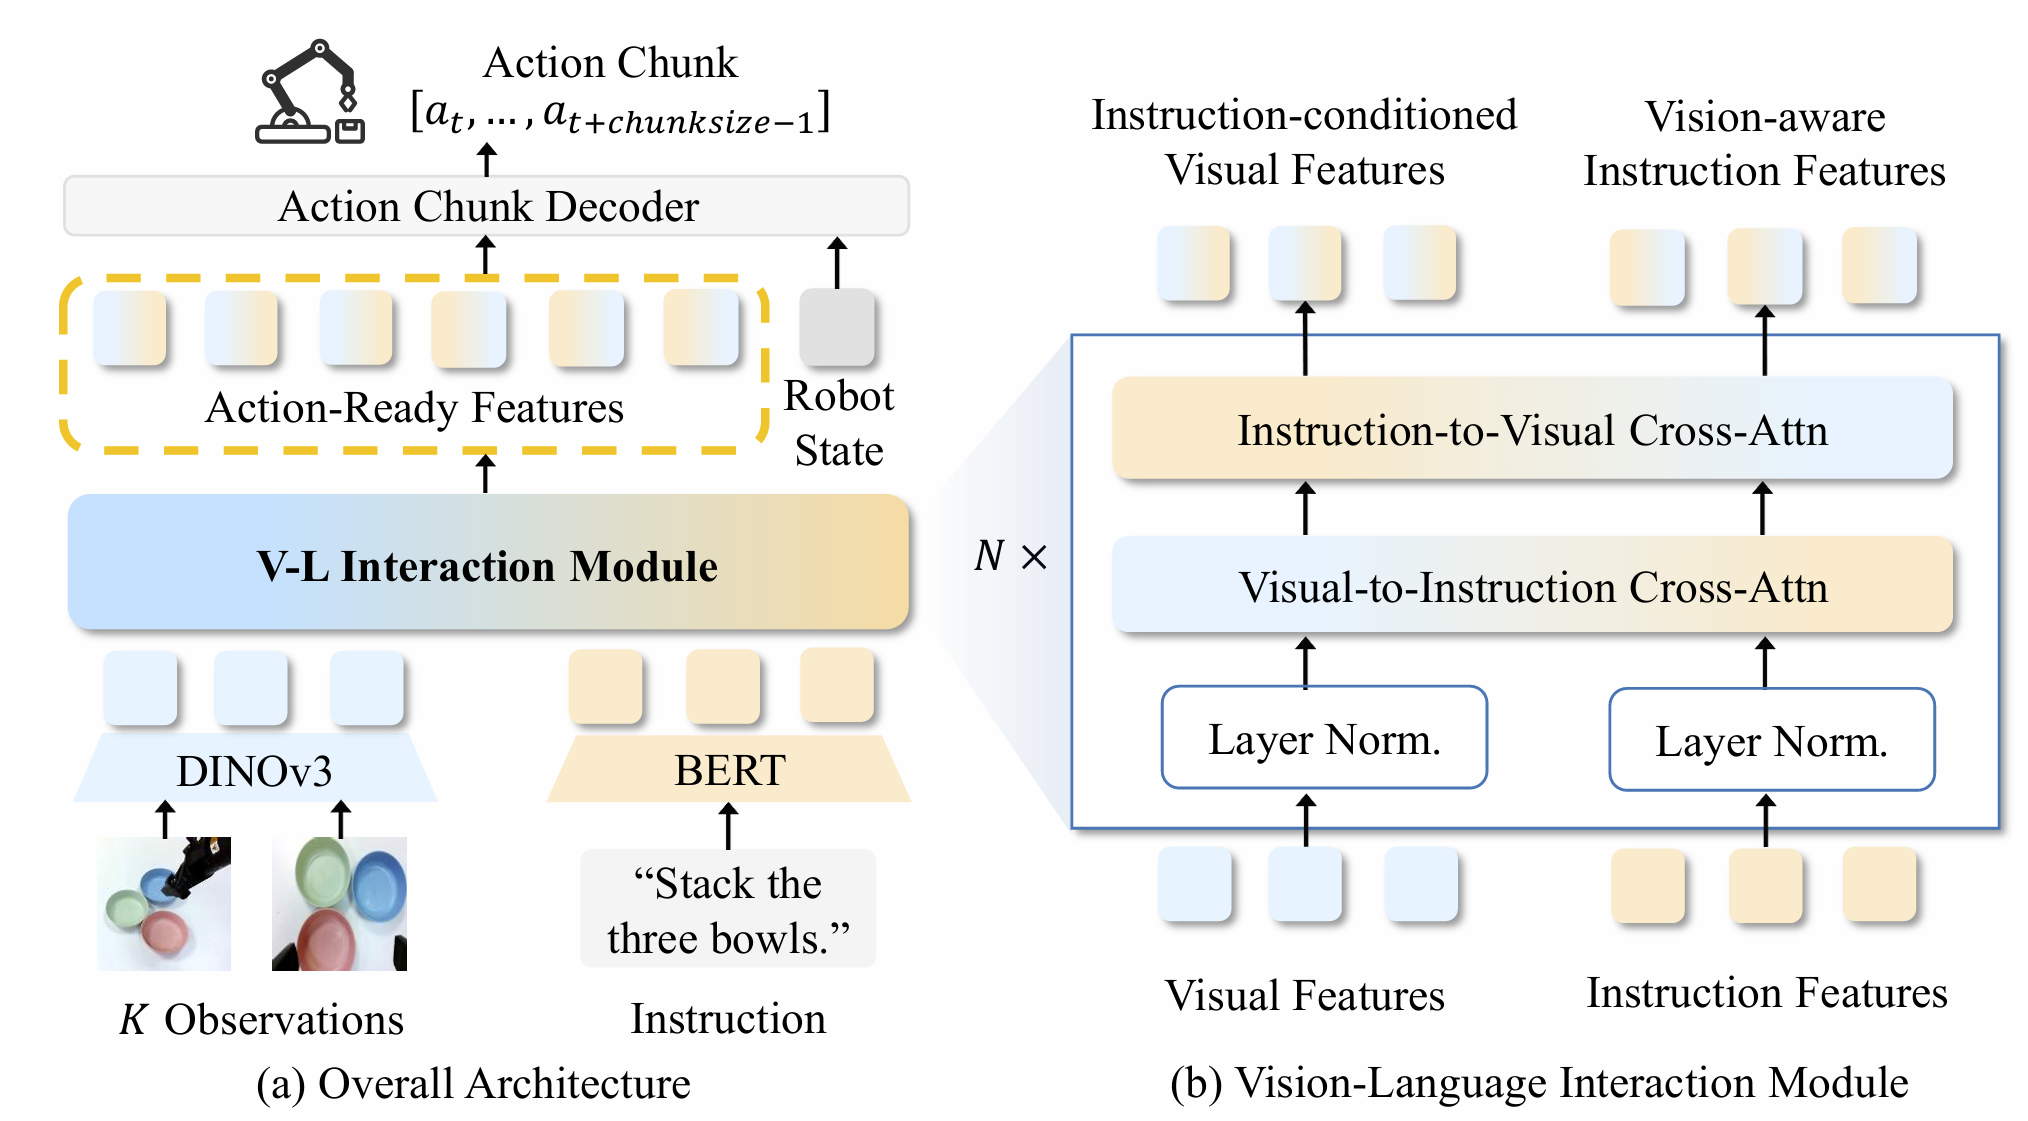
原始结构图来自仓库 assets/figures/architecture-overview.png。双设备设计保留其模型语义:视觉与语言特征经过双向交互,生成 action-ready features;机器人状态通过独立投影后,与融合特征一起送入 ACT 解码器。
LIBERO 默认配置包含 6 层交互模块、3 层 ACT 解码器;实际运行以 checkpoint 的 model_config 为准。BERT 在线编码,不将“冻结参数”误写成“离线文本特征缓存”。
传输契约
| 内容 | split v1 约束 |
|---|---|
| 图像张量 | [1, 2, 3, 256, 256],RGB 预处理后传输 |
| 状态张量 | [1, 8] |
| 精度 | bf16 / fp32,两端一致 |
| 动作 | 最多 12 步,每步 7 维,有限值 |
| 上行 | 4 字节头长度 + JSON 元信息 + 压缩张量 |
| 下行 | JSON 动作、请求标识、服务标识、计时、可选显存指标 |
| 压缩 | zlib、LZ4、Zstandard,可搭配字节 shuffle |
| 连接 | HTTP/1.1 keep-alive;不自动重放 POST |
无损指的是压缩保留已选精度张量的位模式。FP32 转 BF16 本身不是无损转换。
两个执行线程
Orin 主线程按控制步运行环境;后台 worker 执行预处理、压缩和远程请求,最多一个请求在途。Thor 用锁串行访问模型。异步模式重叠的是请求链路与控制执行,不是在 Thor 上同时运行多个推理请求。
资源边界
“8GB / 128GB”标注设备内存容量,不代表模型实测占用。PyTorch allocator peak 只覆盖框架分配器,不能代替 Jetson 总共享内存、仿真显存或系统峰值。应配合设备侧资源监控记录实机运行。